

2.1 · 全プラットフォーム
お使いの言語に対応
メニュー、ボタン、メッセージが42言語に対応しています(macOSおよびLinuxでは39言語)。アプリはシステム言語に自動で従いますが、詳細設定で手動で選択することも可能です。英語以外の言語はすべて機械翻訳であり、その旨が明記されています。ペルシャ語、アラビア語、ヘブライ語は現在Windowsでのみ提供されています。
アクセス元の地域に基づいてこの言語で表示しています。英語で表示
無料・オープンソース · BSD-3-Clause · v2.1.0
Whisper Transcriber Suite は、faster-whisper、whisper.cpp、または NVIDIA Parakeet を介して、OpenAI の Whisper モデルをお使いのコンピューター上だけで実行します。音声や動画をドラッグ&ドロップするだけで、タイムスタンプ付きの文字起こしが得られます。クラウド不要、アカウント不要、分単位の利用料もかかりません。
製品ツアー
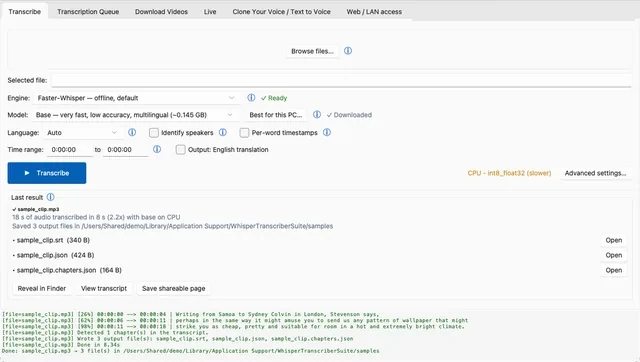
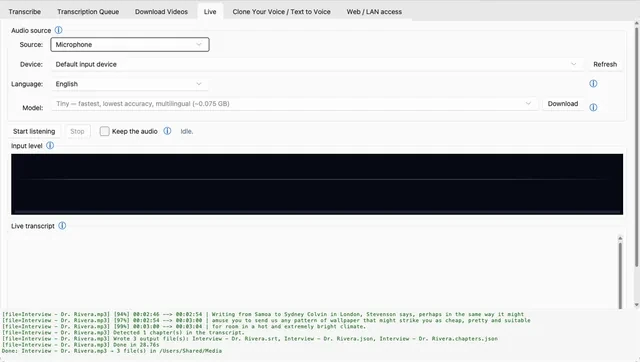
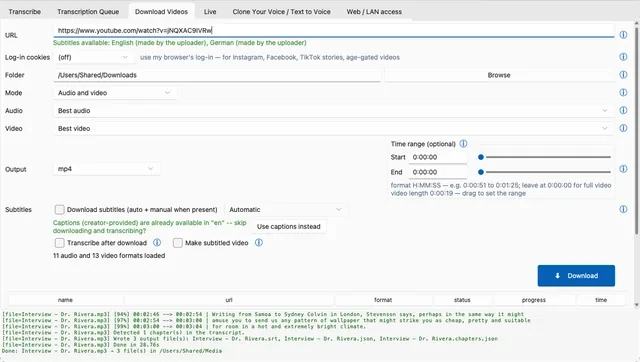
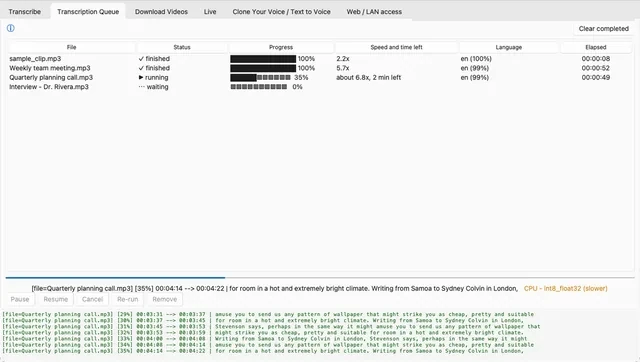
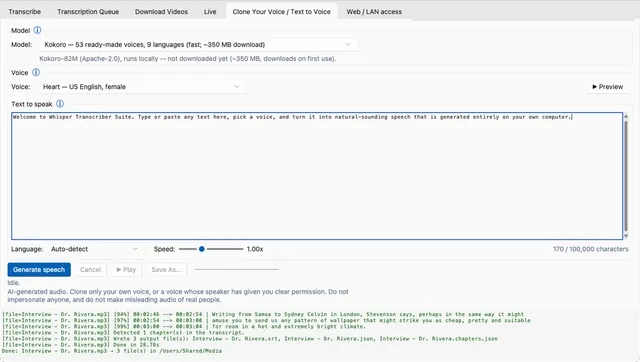
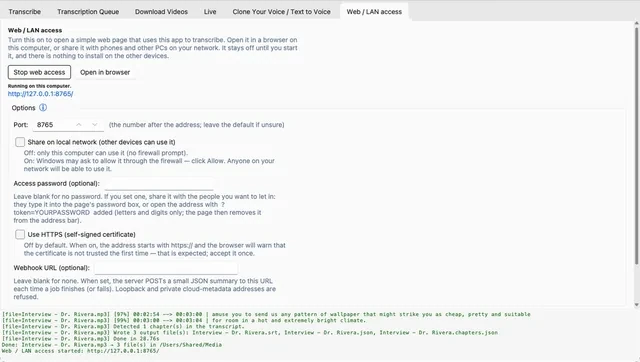
ファイルをドロップし、オプションを選んで「文字起こし」を押すだけ。キュー、ダウンロード、ライブ録音、音声クローン、LAN共有といった他の機能も、すべて隣のタブに揃っています。リングをドラッグするか、矢印を使って切り替えられます。
2.1の新機能
42言語に対応したアプリ、長時間の録音でも最後まで途切れない話者ラベル、停電時でも失われないファイル保存、すべてのMacで動作するオンライン機能。その下には、2.0で追加された機能も掲載しています。
2.1 · 全プラットフォーム
メニュー、ボタン、メッセージが42言語に対応しています(macOSおよびLinuxでは39言語)。アプリはシステム言語に自動で従いますが、詳細設定で手動で選択することも可能です。英語以外の言語はすべて機械翻訳であり、その旨が明記されています。ペルシャ語、アラビア語、ヘブライ語は現在Windowsでのみ提供されています。
2.1 · 全プラットフォーム
長時間の録音でも話者名が最後まで正しく維持されるようになり、話者検出が原因で文字起こしがクラッシュすることもなくなりました。また、話者を識別の横で「自動」のままにする代わりに、話者の人数(2〜10人)を指定できるようになりました。
2.1 · 全プラットフォーム
文字起こし、エクスポートファイル、字幕は、既存のファイルを置き換える前にディスクへ完全に書き込まれるため、停電などでファイルが空になる心配がありません。また、すべてのファイルを出力した後にワーカーが停止した場合でも、その文字起こしは完了扱いになります。
2.1 · macOS
アップデート確認や問題の報告、その他のWeb通信が、certificate verify failed エラーで失敗することがなくなりました。
2.0 · 全プラットフォーム
「文字起こしキュー」タブには、各文字起こしの処理速度とおおよその残り時間(例: 約4.8倍速、残り6分)が表示されます。ジョブ完了時には、結果カードに処理速度、モデル、デバイスが報告されます。
2.0 · 全プラットフォーム
「動画のダウンロード」タブでチェックを入れると、リンクが字幕焼き付け済みの<title>-subbed.mp4になります。ダウンロード、文字起こし、字幕の焼き付けが、進捗表示と確実に機能する「キャンセル」ボタンを備えた1つのキュージョブとして実行されます。ダウンロードした動画と文字起こしも保持されます。
2.0 · 全プラットフォーム
完了した文字起こしは、インストール不要・インターネット接続不要で、どのブラウザでも開ける単一の.htmlファイルとして保存できます。タイムスタンプ、話者、チャプター、検索ボックスを備え、単語をクリックするだけでその位置からメディアを再生できます。
2.0 · 全プラットフォーム
「ファイル」メニューにあるスイッチ1つで、アプリをネットワークから完全に遮断できます。ウィンドウ下部の表示で接続が開いているかを確認でき、今すぐオフラインを確認ではテスト接続が拒否される様子を確認できます。使用統計はデフォルトで有効ですが、「ヘルプ」メニューから無効にできます。
2.0 · 全プラットフォーム
出力: 英語への翻訳オプションを使用すると、Whisper独自の翻訳タスクにより、英語以外の音声を1回の処理で直接英語の字幕に変換できます。この機能はデフォルトでオフになっており、すべてのエンジンやモデルで利用できるわけではありません。
2.0 · macOS
設定(Command-comma)付きのアプリメニュー、macOSに連動するライト/ダークモード、システムフォント、FinderからのファイルオープンやDockアイコンへのドロップ、アプリがバックグラウンドにあるときの処理完了通知に対応。
2.0 · Windows
タスクバーボタンに進捗状況や待機中・実行中のジョブ数が表示され、処理完了時には点滅してお知らせします。タイトルバーはダークテーマに連動し、125%や150%のディスプレイ拡大率でもテキストが鮮明に表示されます。
2.0 · 初回起動
新規インストール時には、言語、「高速」または「最高品質」、保存先フォルダーを設定でき、ダウンロード前にモデルサイズを確認できます。また、18秒のパブリックドメインクリップにより、ご自身のファイルを選ぶ前に実際の文字起こし結果を体験できます。
2.0の新機能:Text to Voiceで最大100,000文字のテキストを分割して読み上げ可能になり、更新するボタンで管理者権限なしに動画ダウンローダーを更新できるようになりました。また、従来の更新ダイアログは控えめなアップデートバーに変更され、Video Tilingタブは廃止されました。詳細は変更履歴をご覧ください。
機能
faster-whisper · whisper.cpp · Parakeet
デフォルトのWhisper large-v3に加え、large-v3-turboおよびdistil-large-v3.5にも対応。お使いのハードウェアに最適なバックエンドを選択できます。
14種類のフォーマット
入力ファイルと同じ場所に直接出力。さらに、プロの文字起こしワークフロー向けにoTranscribe、ELAN、InqScribe、Express Scribeにも対応しています。
マイク · システム音声
マイクからの入力やPCで再生中の音声をリアルタイムで文字起こし。自然な区切りで分割されるため、言葉が途中で途切れる心配はありません。
単語ごとのタイムスタンプ
任意の「話者を識別」処理に加え、単語ごとのタイムスタンプや、細かな区間編集ができる時間範囲のクリッピング機能を搭載。
一時停止 · 再開 · 再実行
待機中および実行中のすべてのジョブのステータスをリアルタイム表示。各行の操作も1クリックで自由自在です。
yt-dlp搭載
yt-dlpが対応するすべてのコンテンツに対応し、完了時の自動文字起こしオプションも利用可能。ダウンロードは最初からやり直さず、中断したところから再開できます。
フィルタリング前に音質を測定
最初に各録音の音質を測定し、効果がある場合のみクリーンアップを実行。処理結果を自動で確認し、人の声まで除去してしまった場合は元の状態に戻します。
さらに、AIツール(要約、アクションアイテム、2言語対応SRT作成)、オフライン音声クローン(オプション)、ローカルネットワークモードなども搭載。詳しくはREADMEをご覧ください。
仕組み
文字起こしはお使いのコンピューター上で実行されます。音声データがアップロードされるのは、2つのオプションであるクラウドエンジンのいずれかを有効にした場合のみです。また、文字起こしテキストが外部に送信されるのも、ご自身でリモートAIモデルを接続した場合に限られます。
ローカルディスク上の音声や動画、またはyt-dlpが取得できるあらゆるメディアに対応。メインプロセスで動作するTkインターフェースにより、瞬時にジョブがキューに追加されます。
すべてのジョブは独立した常駐ワーカーサブプロセスで実行されます。Whisperをメモリ上に保持し、改行区切りのJSONで進捗をストリーミング送信するため、ウィンドウがフリーズすることはありません。
ワーカーごとのトークンとハートビートにより確実なルーティングを維持し、ワーカーが応答しなくなった場合もアプリ全体が停止することなく異常を検知できます。
OpenAIのWhisper音声認識モデルをベースに構築され、faster-whisper、whisper.cpp、またはNVIDIA Parakeetを通じてローカルで実行。メディア処理にはyt-dlpとFFmpegを採用しています。
アーキテクチャの詳細を見るステップ別ガイド:YouTube動画をテキスト化 · 動画からSRT字幕を作成 · 話者ラベル付きの文字起こし
ダウンロード · v2.1.0 · 2026-10-12 リリース
専用のPythonランタイム、ffmpeg、ffprobe、yt-dlpなど、必要なものはすべて同梱されています。後からダウンロードが必要なのは音声モデル本体のみ(初回に約1–3 GB)で、完了後はインターネット接続なしで文字起こしが可能です。
Windows あなたにおすすめ
.exe~238 MB
一般的な利用向け — 通常のインストーラー、スタートメニューへのショートカット作成、上書きアップグレードに対応。アプリはコード署名されていないため、Windows SmartScreenにより初回のみ警告が表示される場合があります:詳細情報 → 実行。
インストーラーを入手Windows ポータブル版
.zip~360 MB
解凍して実行するだけ。インストール不要、管理者権限も不要で、USBメモリ上でも快適に動作します。
ZIPを入手macOS あなたにおすすめ
.dmg~275 MB · ~333 MB
一番簡単:ターミナルで1行実行するだけ — 最適なビルドが自動選択され、セキュリティ警告もスキップできます。または、Apple Silicon 用や Intel 用のディスクイメージを直接入手することもできます。
1行でインストールLinux & ソース あなたにおすすめ
Python 3.11+
git clone https://github.com/Milomilo777/whisper-transcriber-suite.git
cd whisper-transcriber-suite
pip install -r requirements.txt
python gui.py
macOS — 1行インストール
お使いの Mac に適したビルド(macOS 14+ では Apple Silicon、それ以外では Rosetta 経由の Intel)をダウンロードし、アプリを Applications にコピーして開きます。curl で取得したファイルは隔離されないため、「開発元が未確認」の警告をクリックしてやり過ごす必要もありません。
A=x64; [ "$(uname -m)" = arm64 ] && [ "$(sw_vers -productVersion | cut -d. -f1)" -ge 14 ] && A=arm64; curl -fL -o /tmp/wts.dmg "https://github.com/Milomilo777/whisper-transcriber-suite/releases/download/v2.1.0/WhisperTranscriberSuite-v2.1.0-macOS-$A.dmg" && hdiutil attach -nobrowse -quiet -mountpoint /tmp/wts-dmg /tmp/wts.dmg && cp -R "/tmp/wts-dmg/Whisper Transcriber Suite.app" /Applications/ && hdiutil detach -quiet /tmp/wts-dmg && rm /tmp/wts.dmg && open "/Applications/Whisper Transcriber Suite.app"従来の方法をご希望ですか?.dmg を開いてアプリを「アプリケーション」にドラッグしてください。初回起動時のみ、右クリック → 開く(macOS 14 以前)、または「システム設定」→「プライバシーとセキュリティ」→ このまま開く(macOS 15+)の操作が必要です。
すべてのリリースとリリースノートは GitHub Releases でご覧いただけます。インストールガイド。
比較
Whisper Transcriber Suite は、お使いのコンピューター上で文字起こしを行える、いくつかの無料オープンソース・デスクトップアプリの1つです。ここでは、他のアプリのほうが適しているケースも含め、Subtitle Edit、Vibe、Buzz との比較を紹介します。すべての根拠となる出典と、さらに2つのアプリ(noScribe と aTrain)を掲載した詳しい比較表をご覧ください。
| 機能 | Whisper Transcriber Suite | Subtitle Edit | Vibe | Buzz |
|---|---|---|---|---|
| 価格、ライセンス | 無料、BSD-3-Clause | 無料、MIT | 無料、MIT | 無料、MIT |
| ダウンロード | Windows インストーラーおよびポータブル ZIP、macOS(Apple silicon、Intel)、Linux(ソースから) | Windows (x64, ARM64)、macOS、Linux (Flatpak, tar.gz) | Windows、macOS、Linux (.deb, .rpm) | Windows、macOS(Intel Mac 向けは 1.4.5 が最終)、Linux (Flatpak, Snap, AppImage)、PyPI |
| GPU アクセラレーション | NVIDIA (CUDA) | NVIDIA (CUDA)、Vulkan | NVIDIA、AMD、Intel (Vulkan / CoreML) | NVIDIA (CUDA)、Apple silicon、Vulkan |
| 署名済み Windows インストーラー | なし | 記載なし | あり(ドキュメントによる) | なし |
| インターフェース言語 | 42(機械翻訳) | 35 | 22 | 16 |
| こんな場合におすすめ | マイクからのリアルタイム文字起こし、動画のダウンロード、14種類の出力形式、OpenAI 互換ルートを備えたローカルネットワークモードも利用したい場合 | 多数の音声認識エンジン(Parakeet、Canary、Qwen3-ASR など)や、公証された Mac アプリを希望する場合 | ドキュメント上で署名済みとされている Windows インストーラーや、AMD や Intel が明記された GPU サポートを必要とする場合 | Linux 向けパッケージ(Flatpak、Snap、AppImage)や PyPI でのインストールを利用したい場合 |
FAQ
他にご不明な点がありますか?GitHub Discussions でご質問ください。
はい。BSD-3-Clause ライセンスで提供されており、サブスクリプションや分単位の利用料は一切かかりません。Whisper モデル自体は初回起動時に一度ダウンロード(約 1〜3 GB)されますが、それ以降はインターネット接続なしで文字起こしが可能です。
いいえ、デフォルトではありません。すべての標準バックエンド — faster-whisper、whisper.cpp、NVIDIA Parakeet — はお使いの端末上でローカルに実行されます。2つのバックエンド(クラウド Gemini-API バックエンドと Google Cloud Speech-to-Text)はオプトイン方式であり、Advanced → Backend でご自身で有効にしない限りオフのままです。使用統計(音声やファイル名は収集されません)はデフォルトで有効ですが、ヘルプ → 使用統計 でオフにできます。アプリは新しいバージョンの有無を1日1回 GitHub で確認しますが、ファイル → オフラインで作業 を有効にすれば、すべてのネットワーク通信を停止できます。
Windows、macOS、Linux です。公開されているダウンロードファイルには、Windows インストーラー、Windows ポータブル ZIP、macOS DMG があります。Linux ではソースから実行します。
srt vtt ass tsv txt json lrc md docx pdf、さらに oTranscribe、ELAN、InqScribe、Express Scribe。
はい — オプションの話者分離(「話者を識別」)に対応し、単語単位のタイムスタンプや時間範囲の切り出しが可能です。
はい、「Live」タブから可能です — マイクやシステム音声を、そのままリアルタイムで文字起こしできます。
はい、yt-dlp が対応するあらゆるサイトに対応しており、ダウンロード完了後に自動で文字起こしするオプションもあります。
はい、文字起こしビューアにあるオプションの「AI ツール」タブから利用可能です — 要約、アクションアイテム、質問、そしてセグメントごとに翻訳して2言語併記の .srt を書き出す機能が含まれます。デフォルトではオフになっています。
はい、オプションの「声のクローン」タブから利用でき、完全にお使いのコンピューター上で動作する OmniVoice (Apache-2.0) を使用します。デフォルトではオフになっており、インストール時にオプトインできます。なお、参照音声をクローンする権限があることを確認する必要があります。
デフォルトでは faster-whisper を使ってモデルをローカルで実行するため、分単位の API 費用は発生せず、音声が端末の外に出ることもありません — 2つのクラウドバックエンドのいずれかを明示的に有効にした場合を除きます。
はい — Web/LAN アクセスモードにより、このコンピューターをネットワーク上の他のデバイスから利用できる文字起こしページにすることができます。
はい。「動画のダウンロード」タブで 字幕付き動画を作成 にチェックを入れると、アプリが動画をダウンロードし、Whisper で文字起こしを行い、ffmpeg で字幕を焼き付けて、動画名に -subbed.mp4 を付けたファイルを生成します。ダウンロードした動画と文字起こしデータは保持され、既存の -subbed.mp4 が上書きされることはありません。
はい。ファイル → オフラインで作業 を選択すると、アップデート確認、使用統計、モデルのダウンロード、リモート AI プロバイダーへの通信が停止します。このモードがオンの間は、ウィンドウ下部のステータス行で接続が開かれているかどうかが表示され、今すぐオフラインを確認 でテスト接続が拒否される様子を確認できます。オフの場合でも、アプリがネットワークに接続するのは、起動時のオンライン設定、毎日のアップデート確認、使用統計(ヘルプ → 使用統計 でオフに設定可能)、およびユーザーが開始したダウンロード時のみです。
バグ報告や機能リクエストは GitHub Issues へ、質問は Discussions へ、その他の要件はメールでお送りください(アドレスは お問い合わせセクション でリクエストに応じて表示されます)。セキュリティに関する報告は、GitHub の非公開の脆弱性報告機能をご利用ください。
お問い合わせとサポート
取材、パートナーシップ、またはバグ報告以外のお問い合わせ。
GitHub Issues
バージョン、OS、および問題を再現できる最小限のファイルを添えてください。
GitHub Discussions
セットアップの相談やアイデア、他のユーザーによる活用事例など。
Whisper Transcriber Suite は無料で、BSD-3-Clause ライセンスのもとオープンに開発されています。作業時間を節約できたなら、GitHub でスターを付けていただけると他の人にも見つけてもらいやすくなります — コーヒーの差し入れも大歓迎です。
ダウンロードありがとうございます! ダウンロードの合間に — もしこのアプリで作業時間を短縮できたら、GitHub で ⭐ を付けていただけると他の人にも見つけてもらいやすくなります。ワンクリックで、無料です。