ฟรีและโอเพนซอร์ส · BSD-3-Clause · v2.1.0

รับเสียงเข้า ส่งข้อความออก ไฟล์เสียงของคุณจะอยู่บนคอมพิวเตอร์ของคุณ

Whisper Transcriber Suite รันโมเดล Whisper ของ OpenAI บนคอมพิวเตอร์ของคุณเองทั้งหมด — ผ่าน faster-whisper, whisper.cpp หรือ NVIDIA Parakeet ลากไฟล์เสียงหรือวิดีโอเข้ามาแล้วรับไฟล์ถอดเสียงพร้อมไทม์สแตมป์กลับไป ไม่มีคลาวด์ ไม่ต้องสร้างบัญชี ไม่มีค่าใช้จ่ายต่อนาที

  • 14รูปแบบข้อความถอดเสียง
  • 2,800+การดาวน์โหลดจนถึงตอนนี้
  • 0การอัปโหลดเสียงโดยค่าเริ่มต้น
  • $0ตลอดไป

ทัวร์ผลิตภัณฑ์

หน้าต่างเดียว หกเครื่องมือ

วางไฟล์ เลือกตัวเลือก แล้วกดถอดเสียง ส่วนอื่นๆ — คิว การดาวน์โหลด การบันทึกสด การโคลนเสียง และการแชร์ผ่าน LAN — อยู่ห่างไปเพียงแท็บเดียว ลากวงแหวน หรือใช้ลูกศร

แอนิเมชัน: บทสัมภาษณ์พร้อมผู้พูดสองคนที่มีป้ายกำกับ บรรยายเป็นคำบรรยายพร้อมเวลา ลิงก์วิดีโอเปลี่ยนเป็นวิดีโอพร้อมคำบรรยาย แคปชันสดจากไมโครโฟน และข้อความถอดเสียงที่บันทึกไว้ข้างไฟล์เป็น SRT, VTT, DOCX และ PDF
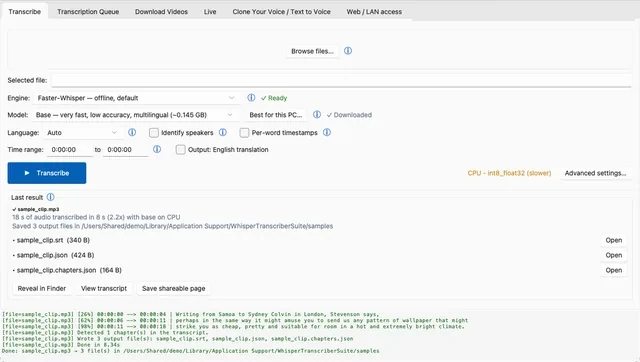
ถอดเสียง
แท็บถอดเสียง: เป้าหมายการวาง ตัวเลือกเอนจิน โมเดลและภาษา ตัวเลือกป้ายกำกับผู้พูดและไทม์สแตมป์ระดับคำ
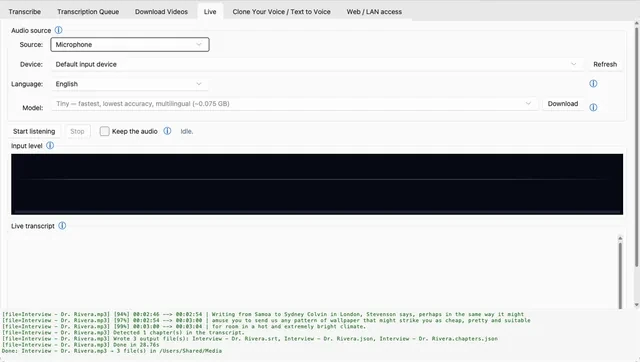
ถ่ายทอดสด
แท็บถ่ายทอดสด: แหล่งเสียงไมโครโฟนหรือระบบ ตัวเลือกภาษาและโมเดล มิเตอร์ระดับอินพุต และบานหน้าต่างข้อความถอดเสียงสด
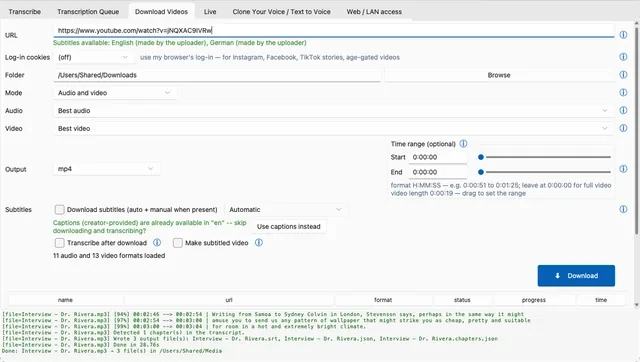
ดาวน์โหลดวิดีโอ
แท็บดาวน์โหลดวิดีโอ: URL พร้อมบรรทัดคำบรรยายที่มี คุกกี้การเข้าสู่ระบบเบราว์เซอร์ รูปแบบ ช่วงเวลา ใช้แคปชันแทน ถอดเสียงหลังดาวน์โหลด และสร้างวิดีโอพร้อมคำบรรยาย
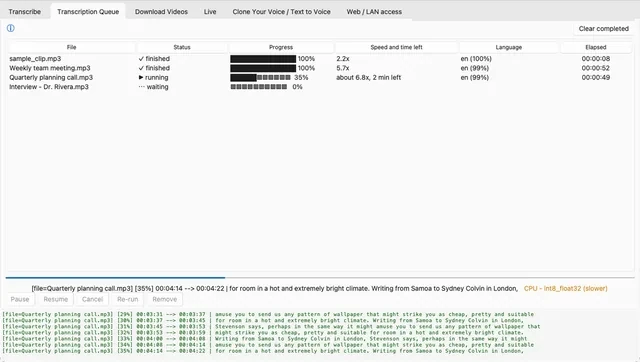
คิวการถอดเสียง
แท็บคิวการถอดเสียง: คอลัมน์ไฟล์ สถานะ ความคืบหน้า ความเร็วและเวลาที่เหลือ ภาษาและเวลาที่ผ่านไป พร้อมปุ่มหยุดชั่วคราว ทำต่อ ยกเลิก ทำซ้ำ และลบ
โคลนเสียงพูดของคุณ
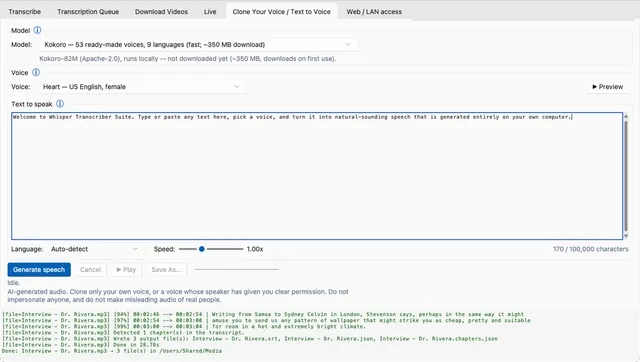
แท็บโคลนเสียงของคุณ / ข้อความเป็นเสียงพูด: โมเดล OmniVoice ตัวอย่างเสียง ข้อความที่จะพูด ภาษาและความเร็ว
การเข้าถึงทางเว็บ / LAN
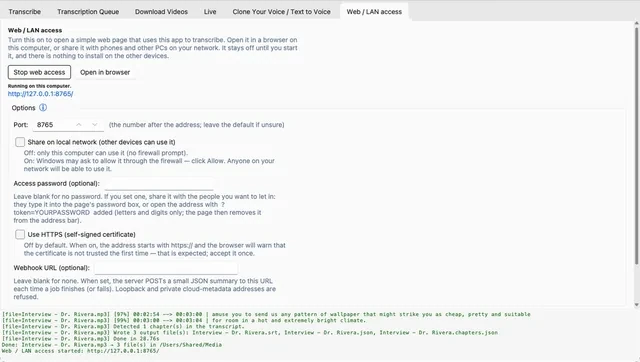
แท็บการเข้าถึงทางเว็บ / LAN: เริ่มการเข้าถึงเว็บ พอร์ต แชร์บนเครือข่ายท้องถิ่น รหัสผ่านการเข้าถึง และตัวเลือก HTTPS

ถอดเสียง

เป้าหมายการวาง ตัวเลือกเอนจิน โมเดลและภาษา ตัวเลือกป้ายกำกับผู้พูดและไทม์สแตมป์ระดับคำ

มีใหม่ใน 2.1

มีอะไรใหม่ใน 2.1 ตอนนี้มีภาษาของคุณแล้ว

แอปใน 42 ภาษา ป้ายกำกับผู้พูดที่ครอบคลุมถึงท้ายบันทึกยาว ไฟล์ที่รอดจากไฟดับ และฟีเจอร์ออนไลน์ที่ทำงานบนทุก Mac ด้านล่างนี้คือสิ่งที่ 2.0 เพิ่มเข้ามา

2.1 · ทุกแพลตฟอร์ม

แอปในภาษาของคุณ

เมนู ปุ่ม และข้อความมีให้เลือก 42 ภาษา (39 ภาษาบน macOS และ Linux) แอปจะเป็นไปตามภาษาของระบบของคุณ หรือคุณสามารถเลือกภาษาได้ใน การตั้งค่าขั้นสูง ทุกภาษายกเว้นอังกฤษเป็นการแปลด้วยเครื่องและมีการระบุไว้เช่นนั้น เปอร์เซีย อาหรับ และฮีบรู ขณะนี้มีให้บริการบน Windows

2.1 · ทุกแพลตฟอร์ม

ป้ายกำกับผู้พูดที่คุณวางใจได้

ชื่อผู้พูดตอนนี้สามารถครอบคลุมถึงท้ายบันทึกยาว การตรวจจับผู้พูดจะไม่ทำให้การถอดเสียงแครชได้อีกต่อไป และข้าง ระบุผู้พูด คุณสามารถตั้งค่าจำนวนคนที่พูดได้ (2 ถึง 10) แทนการปล่อยไว้เป็นอัตโนมัติ

2.1 · ทุกแพลตฟอร์ม

ผลงานของคุณปลอดภัยยิ่งขึ้น

ข้อความถอดเสียง การส่งออก และคำบรรยายจะถูกเขียนลงดิสก์อย่างสมบูรณ์ก่อนจะแทนที่ไฟล์เก่า ดังนั้นไฟดับจะไม่ทิ้งไฟล์ว่างไว้ การถอดเสียงที่ตัวประมวลผลหยุดทำงานหลังจากเขียนไฟล์ทั้งหมดเสร็จแล้วจะถูกนับว่าเสร็จสิ้น

2.1 · macOS

ฟีเจอร์ออนไลน์บนทุก Mac

การตรวจสอบอัปเดต รายงานปัญหา และการค้นหาเว็บอื่นๆ จะไม่ล้มเหลวพร้อมข้อความ certificate verify failed อีกต่อไป

2.0 · ทุกแพลตฟอร์ม

ความเร็วและเวลาที่เหลือ

แท็บคิวการถอดเสียงจะแสดงความเร็วในการถอดเสียงแต่ละครั้งและเวลาที่เหลือโดยประมาณ ตัวอย่างเช่น ประมาณ 4.8x เหลือ 6 นาที การ์ดผลลัพธ์จะรายงานความเร็ว โมเดล และอุปกรณ์เมื่องานเสร็จสิ้น

แท็บคิวการถอดเสียงพร้อมคอลัมน์ความเร็วและเวลาที่เหลือ แสดงประมาณ 6.8x เหลือ 2 นาที สำหรับงานที่กำลังทำงานอยู่

2.0 · ทุกแพลตฟอร์ม

สร้างวิดีโอพร้อมคำบรรยาย

ทำเครื่องหมายที่แท็บดาวน์โหลดวิดีโอ แล้วลิงก์จะกลายเป็น <title>-subbed.mp4 พร้อมเบิร์นคำบรรยายลงไป: ดาวน์โหลด ถอดเสียง และเบิร์นเป็นงานในคิวเดียวพร้อมความคืบหน้าและปุ่มยกเลิกที่ใช้งานได้ ไฟล์ดาวน์โหลดและข้อความถอดเสียงจะถูกเก็บไว้

แท็บดาวน์โหลดวิดีโอที่แสดงบรรทัดคำบรรยายที่มี: อังกฤษและเยอรมัน ปุ่มใช้แคปชันแทน และกล่องทำเครื่องหมายสร้างวิดีโอพร้อมคำบรรยาย

2.0 · ทุกแพลตฟอร์ม

แชร์ข้อความถอดเสียงเป็นหน้าเว็บเพจเดียว

บันทึกข้อความถอดเสียงที่เสร็จแล้วเป็นไฟล์ .html ไฟล์เดียวที่เปิดได้ในเบราว์เซอร์ใดๆ โดยไม่ต้องติดตั้งและไม่ต้องเชื่อมต่ออินเทอร์เน็ต: พร้อมไทม์สแตมป์ ผู้พูด บท และกล่องค้นหา คลิกที่คำใดคำหนึ่งแล้วสื่อจะเล่นจากจุดนั้น

2.0 · ทุกแพลตฟอร์ม

ทำงานออฟไลน์ ที่มองเห็นได้

สวิตช์เดียวภายใต้เมนู File จะตัดการเชื่อมต่อเครือข่ายของแอป บรรทัดที่ด้านล่างของหน้าต่างจะบอกว่ามีการเชื่อมต่ออยู่หรือไม่ และ ตรวจสอบออฟไลน์ตอนนี้ จะแสดงให้เห็นว่าการเชื่อมต่อทดสอบถูกปฏิเสธ สถิติการใช้งานจะเปิดอยู่โดยค่าเริ่มต้นและสามารถปิดได้ภายใต้เมนูวิธีใช้

2.0 · ทุกแพลตฟอร์ม

แปลเสียงพูดเป็นภาษาอังกฤษ

ตัวเลือก ผลลัพธ์: คำแปลภาษาอังกฤษ จะเปลี่ยนเสียงพูดที่ไม่ใช่ภาษาอังกฤษให้เป็นคำบรรยายภาษาอังกฤษในครั้งเดียว โดยใช้ภารกิจการแปลของ Whisper เอง โดยค่าเริ่มต้นจะปิดอยู่และไม่พร้อมใช้งานสำหรับทุกเอนจินหรือโมเดล

2.0 · macOS

Mac ที่ใช้แล้วรู้สึกเหมือน Mac

เมนูแอปที่มีการตั้งค่า (Command-comma), ธีมสว่างและธีมมืดที่เป็นไปตาม macOS, ฟอนต์ของระบบ, ไฟล์ที่เปิดจาก Finder หรือวางบนไอคอน Dock, และการแจ้งเตือนเมื่องานเสร็จสิ้นขณะที่แอปอยู่เบื้องหลัง

2.0 · Windows

ความคืบหน้าบน Taskbar และแถบหัวเรื่องธีมมืด

ปุ่ม Taskbar จะแสดงความคืบหน้า จำนวนงานที่อยู่ในคิวและกำลังทำงาน และจะกะพริบเมื่องานเสร็จสิ้น แถบหัวเรื่องจะเป็นไปตามธีมมืด และข้อความจะคมชัดที่การปรับสเกลการแสดงผล 125% และ 150%

2.0 · เปิดใช้งานครั้งแรก

เริ่มต้นอย่างรวดเร็วและคลิปตัวอย่าง

การติดตั้งใหม่จะถามภาษาของคุณ เร็ว หรือ คุณภาพดีที่สุด และโฟลเดอร์ พร้อมทั้งแสดงขนาดโมเดลก่อนที่จะดาวน์โหลดสิ่งใด คลิปสาธารณสมบัติความยาว 18 วินาทีช่วยให้คุณเห็นผลการถอดเสียงจริงก่อนที่คุณจะเลือกไฟล์ของคุณเอง

อีกหนึ่งฟีเจอร์ใหม่ใน 2.0: Text to เสียงพูด อ่านข้อความได้สูงสุด 100,000 ตัวอักษรทีละส่วน ปุ่ม อัปเดต จะรีเฟรชตัวดาวน์โหลดวิดีโอโดยไม่ต้องใช้สิทธิ์ผู้ดูแลระบบ และแถบอัปเดตแบบเงียบๆ จะมาแทนที่กล่องโต้ตอบการอัปเดต แท็บ Video Tiling ถูกนำออกแล้ว รายละเอียดทั้งหมดอยู่ในบันทึกการเปลี่ยนแปลง

ฟีเจอร์

ทุกสิ่งที่คุณต้องการจากเครื่องมือถอดเสียง ทำงานบนเครื่องของคุณ

แอนิเมชัน: ตัว W ขนาดใหญ่แยกผู้พูดสองคนออกจากกัน แสดงเอนจินในเครื่องอย่าง faster-whisper, whisper.cpp และ Parakeet ที่ทำงานออฟไลน์ และกระจายออกเป็น 14 รูปแบบการถอดเสียง

faster-whisper · whisper.cpp · Parakeet

ถอดเสียงในเครื่องและเป็นส่วนตัว

ใช้ Whisper large-v3 เป็นค่าเริ่มต้น พร้อมด้วย large-v3-turbo และ distil-large-v3.5 เลือกแบ็กเอนด์ที่เหมาะกับฮาร์ดแวร์ของคุณ

14 รูปแบบ

รูปแบบผลการถอดเสียงทุกรูปแบบที่คุณต้องการ

บันทึกไว้ข้างๆ ไฟล์ต้นฉบับของคุณ — พร้อมด้วย oTranscribe, ELAN, InqScribe และ Express Scribe สำหรับเวิร์กโฟลว์การถอดเสียงระดับมืออาชีพ

ไมโครโฟน · เสียงระบบ

ถอดเสียงสด

ถอดเสียงจากไมโครโฟน — หรือสิ่งใดก็ตามที่เครื่องนี้กำลังเล่นอยู่ — แบบเรียลไทม์ การตัดจะทำตรงช่วงเว้นจังหวะตามธรรมชาติเพื่อไม่ให้คำถูกตัดครึ่ง

เวลาประทับระดับคำ

การแยกเสียงผู้พูด

ขั้นตอน "ระบุผู้พูด" แบบเลือกได้ พร้อมด้วยเวลาประทับระดับคำและการตัดช่วงเวลาสำหรับแก้ไขส่วนต่างๆ ได้อย่างแม่นยำ

หยุดชั่วคราว · ทำต่อ · ทำซ้ำ

คิวงานแบบแบตช์

สถานะเรียลไทม์สำหรับทุกงานที่รอดำเนินการและกำลังทำงาน พร้อมการควบคุมทุกแถวอย่างเต็มที่ในคลิกเดียว

ขับเคลื่อนโดย yt-dlp

ดาวน์โหลดวิดีโอและเสียง

ทุกอย่างที่ yt-dlp จัดการได้ พร้อมตัวเลือกให้ถอดเสียงเมื่อดาวน์โหลดเสร็จ การดาวน์โหลดจะทำต่อจากที่ค้างไว้แทนที่จะเริ่มใหม่

วัดค่าก่อนกรอง

การลดสัญญาณรบกวนแบบปรับเปลี่ยนได้

วัดค่าการบันทึกทุกครั้งก่อน และจะทำความสะอาดเฉพาะเมื่อมีประโยชน์ — ตรวจสอบผลลัพธ์ของตัวเองและย้อนกลับหากเสียงพูดถูกตัดออกไป

พร้อมด้วยเครื่องมือ AI (สรุป, รายการที่ต้องทำ, การสร้าง SRT สองภาษา), แท็บโคลนเสียงออฟไลน์แบบเลือกได้ และโหมดเครือข่ายภายใน — อ่านเพิ่มเติมใน README

วิธีการทำงาน

ทำงานบนคอมพิวเตอร์ของคุณ ไฟล์เสียงของคุณจะอยู่ที่นั่น

การถอดเสียงทำงานบนคอมพิวเตอร์ของคุณเอง ไฟล์เสียงของคุณจะถูกอัปโหลดเฉพาะเมื่อคุณเปิดใช้งานหนึ่งในสองเอนจินคลาวด์ที่เลือกได้ และข้อความที่ถอดเสียงแล้วจะถูกส่งออกเฉพาะเมื่อคุณเชื่อมต่อโมเดล AI ระยะไกลด้วยตัวเอง

แอนิเมชัน: ไทม์ไลน์กลายเป็นคำบรรยายที่มีเวลาประทับระดับคำ, คำบรรยายภาษาอังกฤษที่สร้างแบบออฟไลน์ด้วย faster-whisper, whisper.cpp หรือ Parakeet, และ 14 รูปแบบการถอดเสียงโดยไม่ต้องมีบัญชี
  1. 01

    วางไฟล์ หรือวางลิงก์

    ไฟล์เสียงหรือวิดีโอจากดิสก์ หรือสิ่งใดก็ตามที่ yt-dlp ดึงมาได้ อินเทอร์เฟซ Tk ทำงานในโปรเซสหลักและจะจัดคิวงานทันที

  2. 02

    โปรเซสผู้ปฏิบัติงานเก็บโมเดลไว้

    ทุกงานทำงานในโปรเซสย่อยของผู้ปฏิบัติงานที่มีอายุยืนยาวของตัวเอง ซึ่งจะเก็บ Whisper ไว้ในหน่วยความจำและส่งสตรีมความคืบหน้ากลับมาผ่าน JSON ที่คั่นด้วยบรรทัดใหม่ — ดังนั้นหน้าต่างจะไม่มีการค้าง

  3. 03

    ผลการถอดเสียงจะอยู่ข้างๆ ไฟล์ของคุณ

    โทเค็นเฉพาะของผู้ปฏิบัติงานและฮาร์ตบีตช่วยให้การกำหนดเส้นทางมีความแข็งแกร่ง และช่วยให้แอปตรวจจับผู้ปฏิบัติงานที่ค้างได้แทนที่จะค้างตามไปด้วย

สร้างบน โมเดลจดจำเสียงพูด Whisper ของ OpenAI ทำงานในเครื่องผ่าน faster-whisper, whisper.cpp หรือ NVIDIA Parakeet พร้อมด้วย yt-dlp และ FFmpeg สำหรับจัดการสื่อ

อ่านสถาปัตยกรรมทั้งหมด

ดาวน์โหลด · v2.1.0 · วางจำหน่าย 2026-10-12

ดาวน์โหลด ถอดเสียงได้ตั้งแต่คืนนี้

ทุกสิ่งที่จำเป็นถูกรวมไว้แล้ว — รันไทม์ Python ส่วนตัว, ffmpeg, ffprobe และ yt-dlp เฉพาะโมเดลจดจำเสียงพูดเท่านั้นที่จะดาวน์โหลดในภายหลัง (ประมาณ 1–3 GB, ครั้งเดียว) หลังจากนั้น การถอดเสียงจะทำงานได้โดยไม่ต้องเชื่อมต่ออินเทอร์เน็ต

Windows

ตัวติดตั้ง .exe

~238 MB

เหมาะสำหรับคนส่วนใหญ่ — ตัวติดตั้งแบบปกติ มีทางลัดในเมนูเริ่ม และอัปเกรดได้ในที่เดิม แอปนี้ไม่ได้มีการเซ็นโค้ด ดังนั้น Windows SmartScreen อาจแสดงคำเตือนหนึ่งครั้ง: ข้อมูลเพิ่มเติม → เรียกใช้ต่อไป

รับตัวติดตั้ง

Windows แบบพกพา

แบบพกพา .zip

~360 MB

แตกไฟล์แล้วรันได้เลย ไม่ต้องติดตั้ง ไม่ต้องใช้สิทธิ์ผู้ดูแลระบบ พกพาไปใช้บน USB สติกได้สบาย

รับไฟล์ ZIP

macOS

Disk image .dmg

~275 MB · ~333 MB

วิธีที่ง่ายที่สุด: ใช้คำสั่งเดียวใน Terminal — จะเลือกเวอร์ชันที่เหมาะสมและข้ามคำเตือนความปลอดภัยไป หรือจะดาวน์โหลด disk image สำหรับ Apple Silicon หรือ Intel ก็ได้

ติดตั้งด้วยคำสั่งเดียว

Linux & source

บิลด์จาก source

Python 3.11+

git clone https://github.com/Milomilo777/whisper-transcriber-suite.git
cd whisper-transcriber-suite
pip install -r requirements.txt
python gui.py
คู่มือสำหรับ source
แอนิเมชัน: คำว่า Sound in จะกลายเป็นไฟล์ถอดเสียงพร้อมเวลาของผู้พูดสองคน บันทึกเป็น SRT, DOCX และ PDF โดยไม่ต้องมีบัญชีและไม่ต้องอัปโหลด

macOS — ติดตั้งด้วยคำสั่งเดียว

วางลงใน Terminal เป็นอันเสร็จ

ดาวน์โหลดเวอร์ชันที่เหมาะสมสำหรับ Mac ของคุณ (Apple Silicon บน macOS 14+ หรือไม่ก็ Intel ผ่าน Rosetta), คัดลอกแอปไปยัง Applications และเปิดใช้งาน ไฟล์ที่ดาวน์โหลดโดย curl จะไม่ถูกกักกัน จึงไม่มีคำเตือน "unidentified developer" ให้ต้องคลิกข้าม

A=x64; [ "$(uname -m)" = arm64 ] && [ "$(sw_vers -productVersion | cut -d. -f1)" -ge 14 ] && A=arm64; curl -fL -o /tmp/wts.dmg "https://github.com/Milomilo777/whisper-transcriber-suite/releases/download/v2.1.0/WhisperTranscriberSuite-v2.1.0-macOS-$A.dmg" && hdiutil attach -nobrowse -quiet -mountpoint /tmp/wts-dmg /tmp/wts.dmg && cp -R "/tmp/wts-dmg/Whisper Transcriber Suite.app" /Applications/ && hdiutil detach -quiet /tmp/wts-dmg && rm /tmp/wts.dmg && open "/Applications/Whisper Transcriber Suite.app"

อยากทำตามวิธีเดิม? เปิด .dmg แล้วลากแอปไปที่ Applications; การเปิดใช้งานครั้งแรกจะต้องคลิกขวา → เปิด (macOS 14 และเก่ากว่า) หรือไปที่ System Settings → ความเป็นส่วนตัว & Security → เปิดอยู่ดี (macOS 15+)

ทุกเวอร์ชันพร้อมบันทึกประกอบ อยู่บน GitHub Releases คู่มือติดตั้

เปรียบเทียบ

เปรียบเทียบกับแอป Whisper อื่นๆ อย่างไร?

Whisper Transcriber Suite เป็นหนึ่งในแอปเดสก์ท็อปฟรีและโอเพนซอร์สหลายตัวที่ถอดเสียงบนคอมพิวเตอร์ของคุณเอง นี่คือการเปรียบเทียบกับ Subtitle Edit, Vibe และ Buzz รวมถึงกรณีที่แอปอื่นเหมาะสมกว่า อ่านการเปรียบเทียบฉบับเต็ม พร้อมแหล่งอ้างอิงสำหรับทุกข้อมูล และอีกสองแอปคือ noScribe และ aTrain

ตรวจสอบเมื่อ 2026-10-05 กับ README, เอกสาร และการเปิดตัวของแต่ละโปรเจกต์ แอปเปลี่ยนแปลงเร็ว: ดู การเปรียบเทียบฉบับเต็ม สำหรับแหล่งอ้างอิง
คุณสมบัติWhisper Transcriber SuiteSubtitle EditVibeBuzz
ราคา, ลิขสิทธิ์ฟรี, BSD-3-Clauseฟรี, MITฟรี, MITฟรี, MIT
ดาวน์โหลดตัวติดตั้ง Windows และ ZIP แบบพกพา, macOS (Apple silicon, Intel); Linux จาก sourceWindows (x64, ARM64), macOS, Linux (Flatpak, tar.gz)Windows, macOS, Linux (.deb, .rpm)Windows, macOS (1.4.5 เป็นเวอร์ชันสุดท้ายสำหรับ Intel Macs), Linux (Flatpak, Snap, AppImage), PyPI
การเร่งความเร็วด้วย GPUNVIDIA (CUDA)NVIDIA (CUDA), VulkanNVIDIA, AMD, Intel (Vulkan / CoreML)NVIDIA (CUDA), Apple silicon, Vulkan
ตัวติดตั้ง Windows ที่ลงชื่อดิจิทัลไม่ไม่ระบุใช่ ตามเอกสารของแอปไม่
ภาษาของอินเทอร์เฟซ42 ภาษา (แปลด้วยเครื่อง)352216
เลือกแอปนี้ถ้าคุณต้องการใช้ไมโครโฟนแบบเรียลไทม์, ดาวน์โหลดวิดีโอ, รูปแบบไฟล์ 14 แบบ และโหมดเครือข่ายภายในเครื่องที่รองรับเส้นทางแบบ OpenAIคุณต้องการใช้เอนจินถอดเสียงหลายตัว (Parakeet, Canary, Qwen3-ASR และอื่นๆ) หรือแอป Mac ที่ผ่านการรับรองโดย Apple (notarized)คุณต้องการตัวติดตั้ง Windows ที่เอกสารระบุว่าลงชื่อดิจิทัลแล้ว หรือการรองรับ GPU ที่ระบุชื่อ AMD และ Intelคุณต้องการแพ็กเกจ Linux (Flatpak, Snap, AppImage) หรือการติดตั้ผ่าน PyPI

คำถามที่พบบ่อย

คำถามที่ถามบ่อย

มีคำถามอื่นไหม? ไปถามกันได้ใน GitHub Discussions

Whisper Transcriber Suite ใช้งานได้ฟรีหรือไม่?

ใช่ อยู่ภายใต้ลิขสิทธิ์ BSD-3-Clause ไม่มีการสมัครสมาชิกและไม่มีค่าใช้จ่ายต่อนาที โมเดล Whisper จะดาวน์โหลดเพียงครั้งเดียว (ประมาณ 1-3 GB) เมื่อเปิดใช้งานครั้งแรก หลังจากนั้น การถอดเสียงจะทำงานได้โดยไม่ต้องเชื่อมต่ออินเทอร์เน็ต

แอปอัปโหลดไฟล์เสียงหรือวิดีโอของฉันไปที่อื่นหรือไม่?

ไม่ ไม่ใช่ค่าเริ่มต้น แบ็กเอนด์เริ่มต้นทุกตัว — faster-whisper, whisper.cpp, NVIDIA Parakeet — ทำงานบนเครื่องของคุณเอง มีแบ็กเอนด์สองตัวที่ต้องเลือกใช้เท่านั้น (แบ็กเอนด์คลาวด์ Gemini-API และ Google Cloud Speech-to-Text) และทั้งคู่จะปิดอยู่จนกว่าคุณจะเปิดใช้งานเองที่ Advanced → Backend สถิติการใช้งาน (ไม่มีเสียงและชื่อไฟล์) จะเปิดอยู่โดยค่าเริ่มต้นและปิดได้ที่ วิธีใช้ → สถิติการใช้งาน แอปจะตรวจสอบเวอร์ชันใหม่จาก GitHub วันละครั้ง และ ไฟล์ → ทำงานออฟไลน์ จะหยุดการใช้เครือข่ายทั้งหมด

แอปรันบนแพลตฟอร์มใดบ้าง?

Windows, macOS และ Linux ไฟล์ดาวน์โหลดที่เผยแพร่คือตัวติดตั้งสำหรับ Windows, ไฟล์ ZIP แบบพกพาสำหรับ Windows และไฟล์ DMG สำหรับ macOS ส่วน Linux รันจากซอร์สโค้ด

แอปสามารถสร้างไฟล์ถอดเสียงในรูปแบบใดบ้าง?

srt vtt ass tsv txt json lrc md docx pdf รวมถึง oTranscribe, ELAN, InqScribe และ Express Scribe

แอปสามารถระบุได้ว่าใครกำลังพูดอยู่หรือไม่?

ใช่ — มีการแยกเสียงผู้พูดแบบเลือกใช้ได้ ("ระบุผู้พูด"), พร้อมการประทับเวลาระดับคำและการตัดช่วงเวลา

แอปสามารถถอดเสียงจากไมโครโฟนหรือเสียงระบบแบบเรียลไทม์ได้หรือไม่?

ใช่, จากแท็บ Live — ไมโครโฟนหรือเสียงระบบ, จะถูกถอดเสียงขึ้นมาทันทีที่ได้ยิน

แอปสามารถดาวน์โหลดและถอดเสียงวิดีโอออนไลน์ เช่น จาก YouTube ได้หรือไม่?

ได้ สำหรับทุกเว็บไซต์ที่ yt-dlp รองรับ พร้อมขั้นตอนถอดเสียงเมื่อดาวน์โหลดเสร็จเป็นตัวเลือก

แอปสามารถสรุปไฟล์ถอดเสียง ดึงรายการสิ่งที่ต้องทำ หรือตอบคำถามเกี่ยวกับไฟล์ถอดเสียงได้หรือไม่?

ใช่, ผ่านแท็บ เครื่องมือ AI แบบเลือกใช้ได้ในตัวดูผลถอดเสียง — สรุป, สิ่งที่ต้องทำ, ถาม, และการแปลทีละช่วงที่เขียนเป็น .srt สองภาษา โดยค่าเริ่มต้นจะปิดอยู่

แอปสามารถโคลนเสียงและให้พูดข้อความใหม่ได้หรือไม่?

ใช่, ผ่านแท็บ Clone Your เสียงพูด แบบเลือกใช้ได้, โดยใช้ OmniVoice (Apache-2.0) บนเครื่องของคุณเท่านั้น ปิดอยู่โดยค่าเริ่มต้น; เลือกใช้ได้ตอนติดตั้ง และคุณต้องยืนยันว่าคุณได้รับอนุญาตให้โคลนเสียงอ้างอิงนั้นแล้ว

สิ่งนี้ต่างจากการเรียก Whisper API โดยตรงอย่างไร?

โดยค่าเริ่มต้น โมเดลจะทำงานบนเครื่องของคุณผ่าน faster-whisper จึงไม่มีค่าใช้จ่าย API ต่อนาทีและไม่มีเสียงใดออกจากเครื่องของคุณ — เว้นแต่คุณจะเลือกใช้แบ็กเอนด์คลาวด์หนึ่งในสองตัวอย่างชัดแจ้ง

หลายคนบนเครือข่ายเดียวกันสามารถใช้งานแอปได้โดยไม่ต้องติดตั้งบนทุกเครื่องหรือไม่?

ใช่ — โหมดการเข้าถึง Web/LAN จะเปลี่ยนเครื่องนี้ให้กลายเป็นหน้าถอดเสียงที่อุปกรณ์อื่นๆ บนเครือข่ายเข้ามาใช้งานได้

มีอะไรใหม่ในเวอร์ชัน 2.1?

เมนู, ปุ่ม และข้อความ มีให้เลือก 42 ภาษา (แปลด้วยเครื่องและระบุไว้ดังนั้น); ป้ายชื่อผู้พูดสามารถรองรับได้ถึงท้ายของบันทึกเสียงที่ยาวและคุณสามารถตั้งค่าจำนวนคนที่พูดได้; ผลถอดเสียง, ไฟล์ส่งออก และคำบรรยาย จะถูกเขียนลงดิสก์ให้เรียบร้อยก่อนที่จะไปแทนที่ไฟล์เก่า; ฟีเจอร์ออนไลน์ทำงานได้บนทุก Mac เวอร์ชัน 2.0 ได้เพิ่มความเร็วและเวลาที่เหลือของคิว, วิดีโอพร้อมคำบรรยายจากลิงก์, ผลถอดเสียงเป็นหน้าเว็บออฟไลน์หน้าเดียว, โหมด ทำงานออฟไลน์ ที่ตรวจสอบได้ และการแปลเป็นภาษาอังกฤษ ดู มีอะไรใหม่ใน 2.1 และ บันทึกการเปลี่ยนแปลง

แอปสามารถเปลี่ยนลิงก์วิดีโอให้เป็นวิดีโอพร้อมคำบรรยายได้หรือไม่?

ใช่ ในแท็บ ดาวน์โหลดวิดีโอ ให้ติ๊ก สร้างวิดีโอพร้อมคำบรรยาย: แอปจะดาวน์โหลดวิดีโอ, ถอดเสียงด้วย Whisper และเผาคำบรรยายลงไปด้วย ffmpeg, สร้างไฟล์ที่มีชื่อตามวิดีโอพร้อม -subbed.mp4 ไฟล์ที่ดาวน์โหลดและผลถอดเสียงจะถูกเก็บไว้ และจะไม่มีการเขียนทับไฟล์ -subbed.mp4 ที่มีอยู่แล้วเด็ดขาด

ฉันสามารถตัดการเชื่อมต่อเครือข่ายของแอปได้อย่างสมบูรณ์หรือไม่?

ใช่ ไฟล์ → ทำงานออฟไลน์ จะหยุดการตรวจสอบอัปเดต, สถิติการใช้งาน, การดาวน์โหลดโมเดล และผู้ให้บริการ AI ระยะไกล ขณะที่เปิดอยู่ จะมีบรรทัดที่ด้านล่างของหน้าต่างระบุว่ามีการเชื่อมต่ออยู่หรือไม่ และ ตรวจสอบออฟไลน์ตอนนี้ จะแสดงว่าการทดสอบการเชื่อมต่อถูกปฏิเสธ เมื่อปิด แอปจะติดต่อเครือข่ายเฉพาะสำหรับการตั้งค่าออนไลน์ตอนเปิดใช้งาน, การตรวจสอบอัปเดตประจำวัน, สถิติการใช้งาน (ปิดได้ที่ วิธีใช้ → สถิติการใช้งาน) และการดาวน์โหลดที่คุณเริ่มต้น

ฉันจะติดต่อโครงการนี้ได้อย่างไร?

รายงานบั๊กและขอฟีเจอร์ใหม่ไปที่ GitHub Issues, ถามคำถามได้ที่ Discussions, และเรื่องอื่นๆ ทางอีเมล (จะแสดงที่อยู่เมื่อร้องขอใน ส่วนติดต่อ) รายงานความปลอดภัยให้ส่งผ่านการรายงานช่องโหว่แบบส่วนตัวของ GitHub

ติดต่อ & สนับสนุน

พูดคุยกับเรา วิธีใช้และช่วยกันพัฒนาต่อ

สนับสนุนโปรเจกต์

Whisper Transcriber Suite เป็นโปรแกรมฟรีและอยู่ภายใต้ลิขสิทธิ์ BSD-3-Clause พัฒนาและดูแลแบบเปิดเผย หากโปรแกรมนี้ช่วยประหยัดเวลาของคุณได้ การกดดาวบน GitHub จะช่วยให้ผู้อื่นค้นพบโปรแกรมนี้ — และการเอากาแฟมาฝากก็เป็นที่ยินดีเสมอ